前言
之前写过两篇 CC 攻击相关的文章:一篇《网站CPU突然跑满,很可能是CC攻击》写的是怎么发现和判断CC攻击,一篇《如何在VPS上配置网站CC防护》写的是平时的防护配置。但如果真被攻击到,我们还需要一份应急预案,理性快速地按照流程来处理。
我的运行环境:Ubuntu 22.04 + Nginx + PHP-FPM,面板用的 1Panel,下面的命令都基于这个环境。
先确认是CC攻击
应急的第一步不是封 IP,是确认你面对的确实是 CC 攻击,不然直接限流和封禁就全白费。判断方法可参考《网站CPU突然跑满,很可能是CC攻击》写得很细,这里给出三个最快出结论的命令:
# 看 CPU 和负载,htop 是比 top 更直观的进程监控工具,没装用 top 也行
htop

# 看当前连接总数和状态分布,ss 是查看网络连接的工具,比老的 netstat 快
ss -s

# 统计最近日志里请求量最高的 20 个 IP
tail -n 2000 /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20 对上这几个特征基本就能确认是CC攻击:CPU 居高不下但带宽没涨、大量请求集中在搜索和登录这几个动态接口、请求来源 IP 分散但频率异常整齐。确认了再动手,方向才不会错。
临时止血把阈值调狠
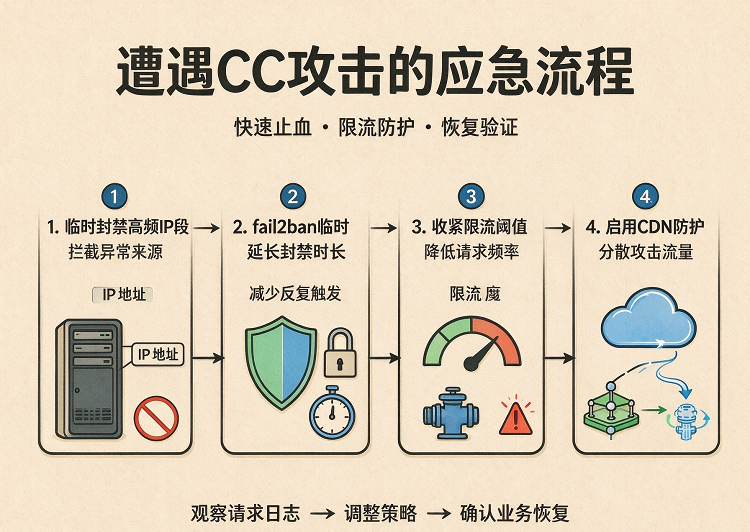
确认是 CC 之后,前十分钟能做的就是收紧平时的防护配置。平时为了不影响正常用户设置了比较温和的阈值,应急期间统统调狠:
# 临时封禁高频 IP 段(网段换成你日志里筛出来的)
iptables -A INPUT -p tcp -s 1.2.3.0/24 -j DROP

# 把 fail2ban 的封禁时长临时延长到 24 小时
fail2ban-client set nginx-limit-req bantime 86400
限流阈值也临时收紧,平时 5r/s 的接口先砍到 2r/s,burst 同步减半:
limit_req_zone $binary_remote_addr zone=search_limit:10m rate=2r/s; 这里有个我自己疏忽的点:改完配置直接 reload,忘了先跑 nginx -t,结果配置里少了个分号,Nginx 直接没起来,网站 502,比 CC 攻击还彻底。(╯°□°)╯︵ ┻━┻ 所以重载命令务必用 && 串起来,先测试再加载:
nginx -t && systemctl reload nginx 止血的目标不是把攻击彻底挡住,是先把 CPU 从 100% 压下来,让正常用户还能访问,给下一步争取时间。
把防护交到CDN上
应急期间最省心的一步,就是把流量先引到边缘节点过滤。CDN 的基础原理可以参考本站文章《什么是CDN》。在 CDN 控制台把 CC 防护和 WAF 开关打开,高频异常请求就在边缘被拦掉了,回源流量骤减。
我用的是 VMRack 的 CDN,防护策略在控制台里直接配置就行,不用改源站代码;公测期间每月还送 30GB 的免费流量,应急之外平时的加速也可以顺手用上了。关于 VMRack CDN 更多的功能介绍,可以参考等点博客的文章《VMRack免费CDN分享》。
有一点要特别注意:CDN 开了不等于源站就安全了,攻击者还是可能会绕过 CDN 直连源站 IP。所以源站白名单必须同步核对,确认只放行 CDN 回源 IP 段,具体配置可以参考《如何在VPS上配置网站CC防护》。
观察恢复情况再慢慢放开
应急止血操作和 CDN 防护生效后,就是观察期。实时盯着日志,确认高频请求是否退去:
# 实时跟踪访问日志
tail -f /var/log/nginx/access.log

# 隔十几分钟重跑一次确认环节的统计命令,对比攻击前后的变化
tail -n 2000 /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20
判断攻击停没停,可以看这三个信号:
头部 IP 回落。 应急前霸榜的高频 IP,请求数从几千次掉到两位数甚至从榜上消失,统计榜回到正常访客的分布。
接口频率正常。 搜索、登录、评论这些被刷的动态接口,请求间隔拉开,不再出现同一 IP 每秒几次的连打;日志里的 URL 重新散开,访问什么页面的都有。
CPU 回到水位线。 htop 里 CPU 从 90% 附近降回平时的水平,负载也稳定下来。
三个信号都满足后,恢复操作也要讲究顺序:先恢复体验,再动封禁。限流阈值可以逐步放开,封禁反而要加固。
1.把限流阈值和 burst 恢复到平时的水平,重载还是先 nginx -t。限流影响的是正常用户的体验,而 CDN 那层防护还在,可以放心放。
2.封禁不但不解,还要固化下来。应急期间的 iptables 规则重启了就丢了,得让它持久化:
# 安装持久化工具并保存当前规则,重启后封禁依然生效
apt install iptables-persistent -y
netfilter-persistent save
fail2ban 的封禁时长也保持 24 小时不要调回,观察期过了再说。攻击者最盼的就是你攻击一停就解除封禁,换批 IP 再来一波,前功尽弃。
3.把这次攻击的特征固化成规则。从日志里找这次高频请求共用的异常 User-Agent 或固定的 Referer,加进 WAF 或 Nginx 规则里长期拦截——攻击者可以换 IP,但特征一时半会换不掉。源站白名单保持只放行 CDN 回源段,别顺手关了。
4.再观察半天到一天,CPU 和日志都平稳了,才处理解封的事。解封前先拿统计命令再核一遍,确认那段 IP 确实是误伤的真实用户,再逐段放开:
# 确认误伤后,解封单个 IP 或网段
fail2ban-client set nginx-limit-req unbanip 1.2.3.4
iptables -D INPUT -p tcp -s 1.2.3.0/24 -j DROP
应急流程能做到的是控制损失和争取时间,并不是一劳永逸的免疫。攻击者换 IP、换特征是常态,真正减少复发的,还是要把长期防护那几层配齐,再补上这次暴露出来的缺口。
总结
网站遭遇 CC 攻击的应急处理,核心就是按顺序做四件事:
快速确认: CPU 高、带宽正常、动态接口高频请求,三个命令两分钟内确认攻击类型。
临时止血: 封高频 IP 段、延长 fail2ban 封禁时长、收紧限流阈值,把 CPU 压下来。
边缘卸载: 在 CDN 上开启 CC 防护和 WAF,同时核对源站白名单防绕过。
观察恢复: 确认攻击退去后逐步放开配置,别一步到位,事后复盘补缺口。
应急的价值在于把手忙脚乱变成按部就班,真遇上了,照着流程走,处理攻击恢复服务要快很多。