前言
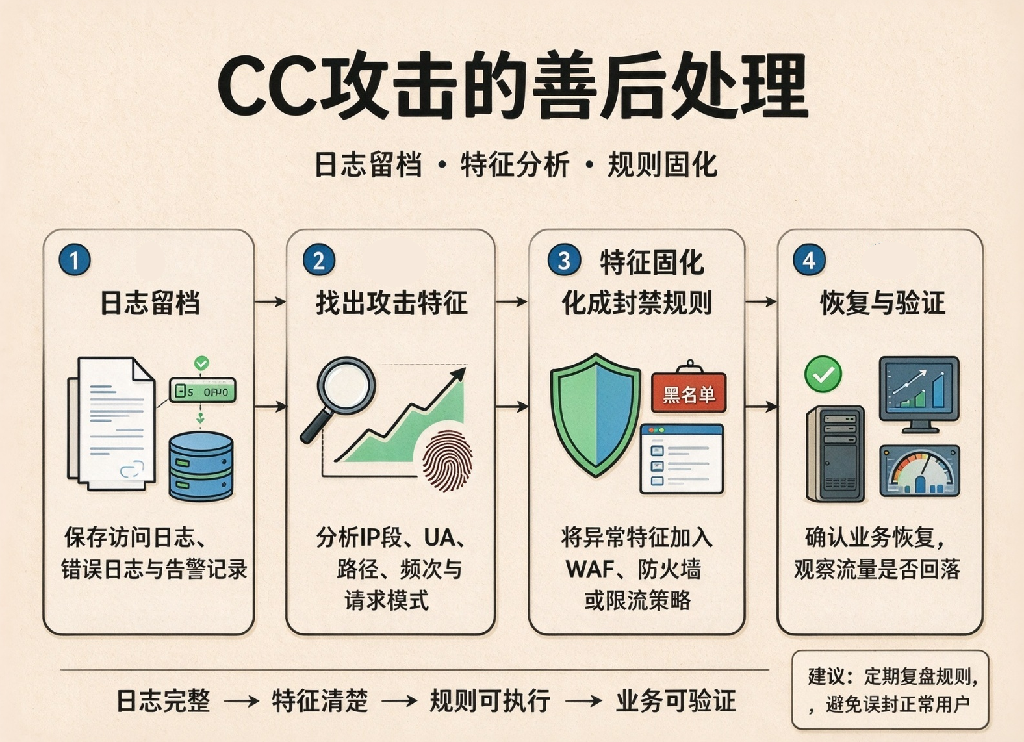
在上一篇文章《网站遭遇CC攻击的应急处理流程》中详细描述了如何在攻击时及时止血。现在攻击退去之后,我们一定要做复盘,因为攻击者可能会换个时间再来,如果没有做好复盘善后,我们还是只能重复一遍手忙脚乱,而复盘的重点就在于攻击者的行为特征,它一直躺在我们的访问日志里。本文就来详细讲一下怎么把这些特征挖出来、固化成封禁规则,以及封完之后怎么验证和复查。
我的环境依旧是 Ubuntu 22.04 + Nginx,命令示例都基于它,其他环境思路相同。
先把日志留档
动手分析之前,第一件事是把攻击时段的日志复制出来单独保存。Nginx 的日志是靠 logrotate 定期轮转的(一个自动切割、压缩旧日志的工具),过不了几天,攻击当天的 access.log 就会被压成 .gz 或者直接删掉,到时想取证都找不到原件:
# 建个目录放证据,当天的日志和已轮转的上一份都拷走
mkdir -p ~/cc-incident

cp /var/log/nginx/access.log ~/cc-incident/access.log.bak

cp /var/log/nginx/access.log.1 ~/cc-incident/access.log.1.bak
如果当时没来得及留档,日志已经被压成 .gz,也不用慌,zgrep 可以直接在压缩文件里搜索,不用先解压。
从日志里找出攻击特征
一份访问日志里,一次CC攻击通常能提炼出不止一个特征:高频的IP、异常集中的URI、陌生的User-Agent、畸形的状态码分布。特征挖得越全,后面的规则就配得越准。
找出请求峰值的时间段。 攻击一般是脉冲式的,先定位它最猛的时段,后面的分析都聚焦在这段时间里:
# 按分钟统计攻击时段的请求数,一眼看出哪几分钟最凶
grep '05/Nov/2026:10:' ~/cc-incident/access.log.bak | cut -d: -f2-3 | uniq -c
看请求都打在哪些路径上。 CC攻击通常死磕少数几个动态接口,URI分布一统计就现形:
# 统计请求路径 Top 20,awk 是文本按列处理的工具,$7 是日志里的请求路径
awk '{print $7}' ~/cc-incident/access.log.bak | sort | uniq -c | sort -rn | head -20
统计User-Agent。 攻击脚本用的UA经常是一眼假的:python-requests、空UA、或者一长串无意义的随机字符:
# 日志里引号内的第6个字段是 User-Agent,按出现次数排序
awk -F'"' '{print $6}' ~/cc-incident/access.log.bak | sort | uniq -c | sort -rn | head -20
看状态码分布。 正常时段日志里以200为主,攻击时段会冒出大量499、502,比例一眼就能看出来:
# $9 是状态码,统计每种状态码出现了多少次
awk '{print $9}' ~/cc-incident/access.log.bak | sort | uniq -c | sort -rn
确认IP的来路。 对统计出来的头部IP,用 whois 查一下归属(一个查询IP注册信息的工具):
whois 203.0.113.45 如果查出来是海外机房的IP段,真人访客的可能性基本为零,可以放心封;如果看着像家宽或者手机网络的IP,就要谨慎,可能是被利用的肉鸡,也可能是误伤真实用户,封之前多掂量一下。
把特征固化成封禁规则
特征到手,接下来让它长期生效。封单IP用 Nginx 的 deny 就够了:
# 放在 server 配置里,或单独一个 deny.conf 再 include 进来
deny 203.0.113.0/24;
deny 198.51.100.77;
nginx -t && systemctl reload nginx 假UA、假Referer这类特征,用一条判断直接拒掉:
# 命中攻击脚本常用的UA就返回403,特征要选攻击者独有的,别把正常工具误伤进来
if ($http_user_agent ~* "python-requests|scrapy|curl/7") {
return 403;
}
IP换了但行为不变的攻击者,交给 fail2ban 的 recidive 监狱去管(它专门盯那些封禁期内又反复进来的累犯,出来一次加刑一次):
# /etc/fail2ban/jail.local 里追加
[recidive]
enabled = true
bantime = 1w
findtime = 1d
maxretry = 3
systemctl restart fail2ban 如果站点前面挂着CDN或高防,别忘了把提炼出的UA、URI特征同步到边缘的防护规则里。比如我现在用的VMRack CDN就自带WAF和CC防护,自定义规则配上以后,同类请求在节点就被拦掉,根本到不了源站。
封完之后的验证与复查
规则配完不算完,要验证它真的在工作。拿攻击时的特征原样重放一遍:
# 用攻击脚本的同款UA访问,应该看到403
curl -A "python-requests" -I https://your-site.com/

# 换正常浏览器的UA访问,应该还是200
curl -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64)" -I https://your-site.com/
两条命令的返回符合预期,规则才算生效。之后再隔几天复查一遍统计命令,看日志里有没有新的高频IP、新的异常UA冒出来——攻击者不会认输,换IP、换特征是常态,封禁规则是养出来的,不是配一次就一劳永逸的。
另外把 deny 名单里像家宽、手机网络的段定期拎出来核一遍,确认没有误伤到正常用户;真发现误伤,及时解封,别让防护把访客挡在门外。
总结
CC攻击退去后的复盘,核心是四步:
留档: 先把攻击时段的日志拷出来,防被轮转清掉。
取证: 从IP、URI、User-Agent、状态码四个维度提炼特征,whois确认IP来路。
固化: deny封段、假特征一条判断拒掉、recidive盯累犯,特征同步到CDN的防护层。
复查: 重放特征验证规则生效,隔几天复查补新规则,定期核对误伤。
攻击可以顶过去一次两次,真正让站点越来越难被打的,是每一次都把对方的特征留下来,变成自己的规则。